
智能体架构:记忆知识与上下文协同,API 聚合分发决定每百万 tokens 价格与开发者接入
架构瓶颈转移:从检索到认知管理
随着行业从聊天机器人向自主智能体演进,架构层面的瓶颈正在发生转移。难点不再仅仅是数据检索,而是决定智能体应该知道什么、何时应该知道、应该记住多久,以及应该遗忘什么。和人类一样,“知道”是一回事,“记住”是另一回事。由此有了记忆与知识的概念。根据任务上下文判断何时动用现有的各种“知道”并将其调入记忆才是关键。例如,如果我只是想煎个蛋饼,那么此刻并不需要记住如何揉面。智能体必须跨工具、会话、用户和实时系统进行推理。在工程化系统中,我们可以将上下文描述为一种控制平面。“上下文即控制平面”是一种架构范式:组织、行为和情境数据(即谁、什么、为什么)作为系统运营的集中治理层,而不是直接硬编码到各个应用、AI 模型或微服务中。
三大核心组件:上下文、记忆与知识
系统知识就是指我们的策略、治理规则和硬性事实。它相当于系统的官方教科书,保存着核心业务逻辑、严格的策略和数据库。记忆是连接历史数据与实时信号、并将其转化为可供推理状态的关键层。上下文(Context)是智能体在任一时刻正在使用的即时、活跃且临时性的信息,直接位于模型的活跃上下文窗口内。记忆(Memory)提供持久化能力,让智能体能够将信息保留到单次交互之外。知识(Knowledge)是智能体在与用户交互之前就具备的事实、概念和规则基础,属于经过高度精选的数据。我们的目标是:在给定任务上下文、系统知识和记忆的情况下,在正确的时刻将数据转化为正确的记忆状态。
上下文引擎:从提示词到状态系统
为了构建这个系统架构,我们将模型与周边机制分离开来。后文中,我们将这套外围支撑机制称为上下文引擎。它是上下文控制平面的一部分,是负责在信息抵达大模型推理端点之前对其进行选择、过滤、排序、结构化、压缩、安全保护和交付的编排器。它从知识中拉取信息,将其归类到记忆中,并决定在任意给定的毫秒内智能体的上下文应该是什么。这是从简单的提示词工程向系统工程的一次意义深远的转变。提示词工程假定任务就是打磨出更好的指令,而上下文工程假定任务是构建一个动态基底,持续为推理组装出正确的状态。提示词不再是思考“我该向模型提什么问题?”,而是思考“模型当下要做好推理,最小化、价值最高的上下文是什么?”
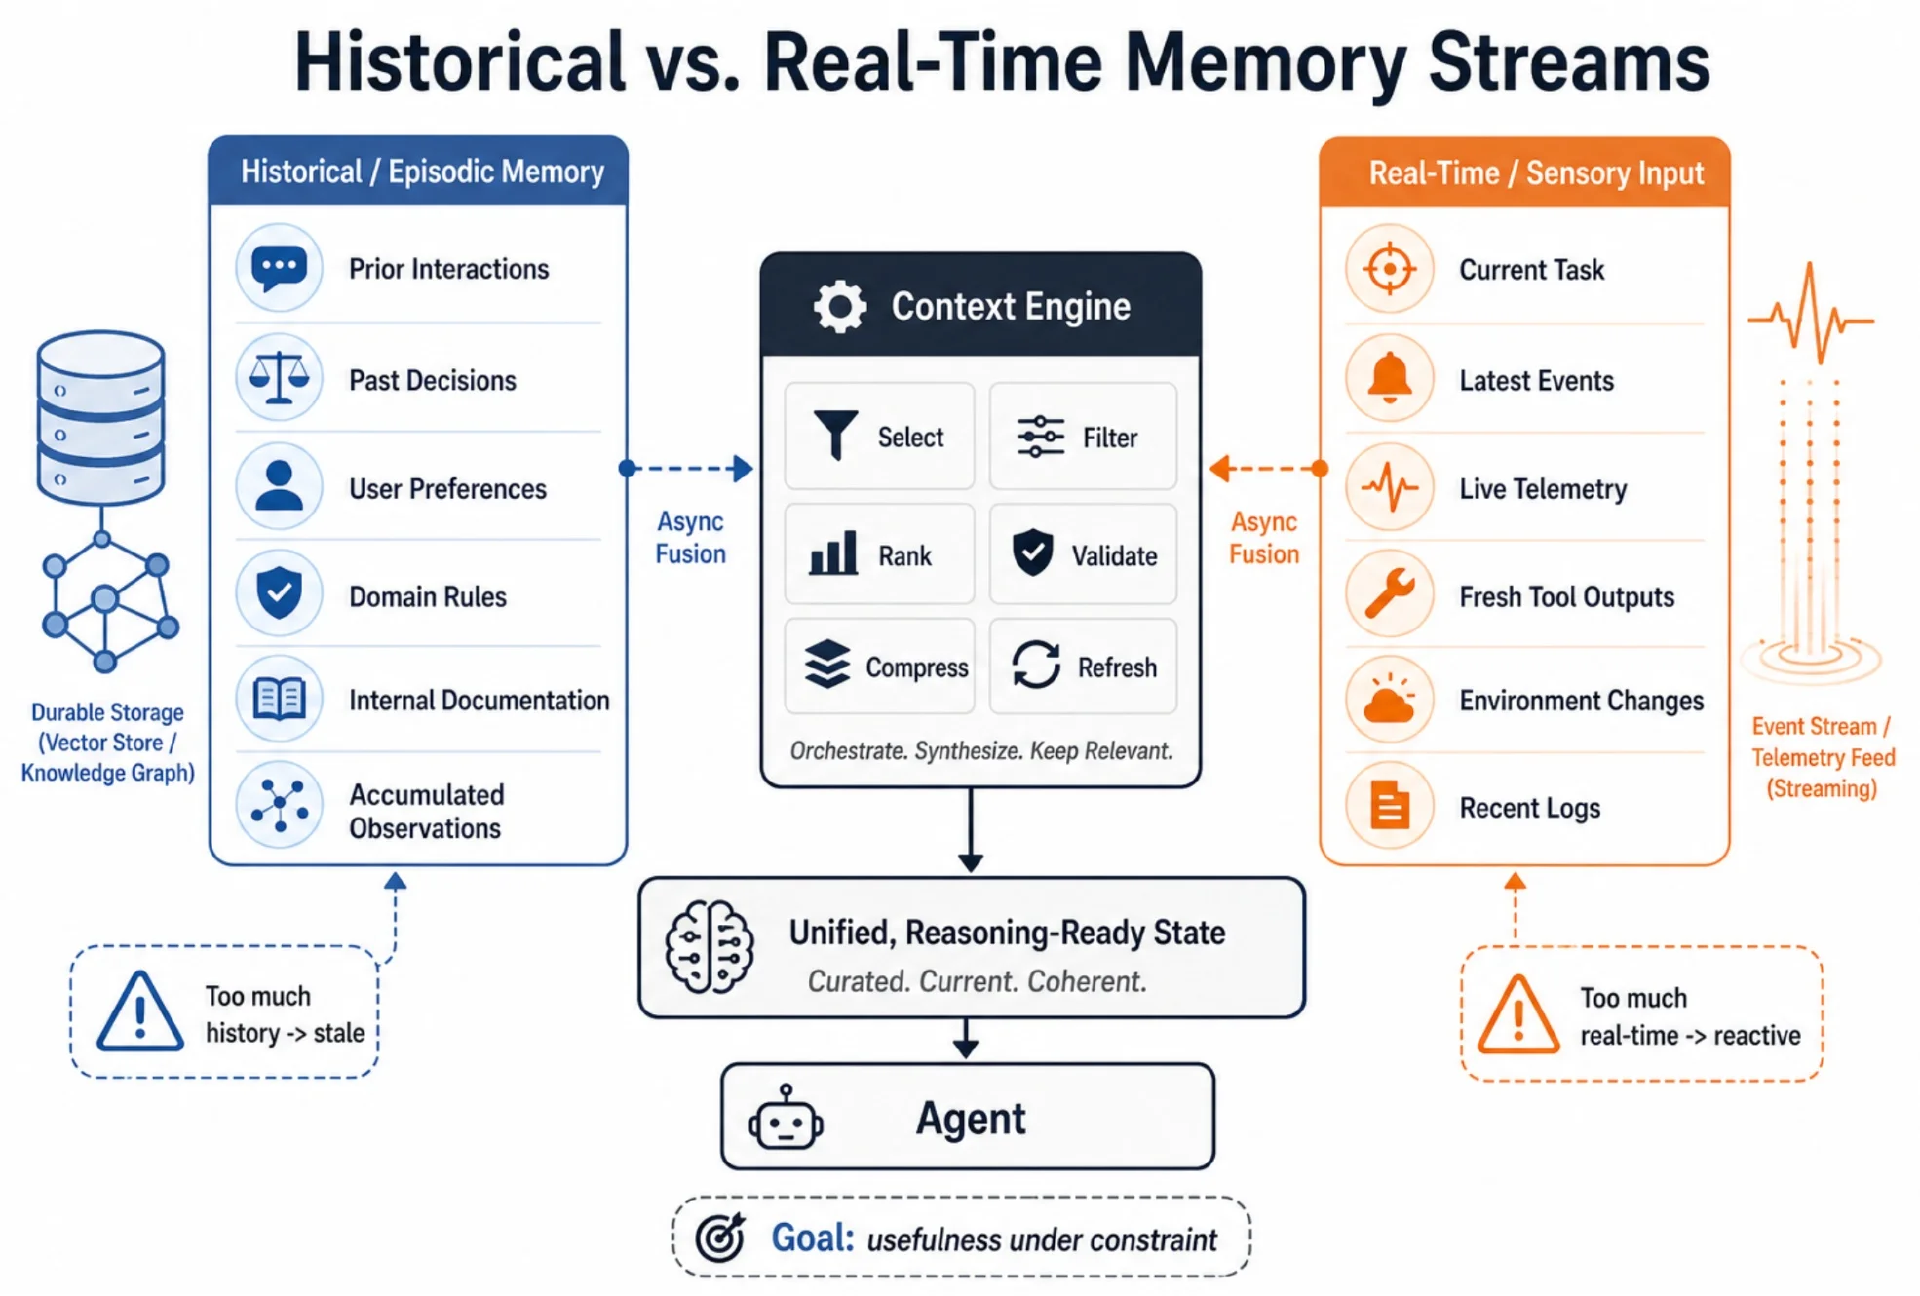
平衡历史记忆与实时输入
健壮的智能体架构必须能够优雅地平衡长期“情景记忆”与即时“感知输入”。历史记忆是长寿命层,包括过往交互、历史决策、用户偏好、领域规则、内部文档和累积的观察记录。它赋予智能体连续性,让系统表现得如同拥有过往经验。实时输入是短寿命层,包括当前任务、最新事件、实时遥测数据、新鲜的工具输出和环境变化。它让智能体立足于当下。向量数据库擅长检索历史性的语义事实,但智能体工作流常常依赖于亚秒级的实时上下文。架构必须异步地融合这些批量与流式数据源,确保智能体基于统一、最新的事实展开行动。如果过度偏向历史记忆,智能体会变得滞后;如果过度偏向实时数据,智能体会变得被动且健忘。
知识提炼与上下文生命周期管理
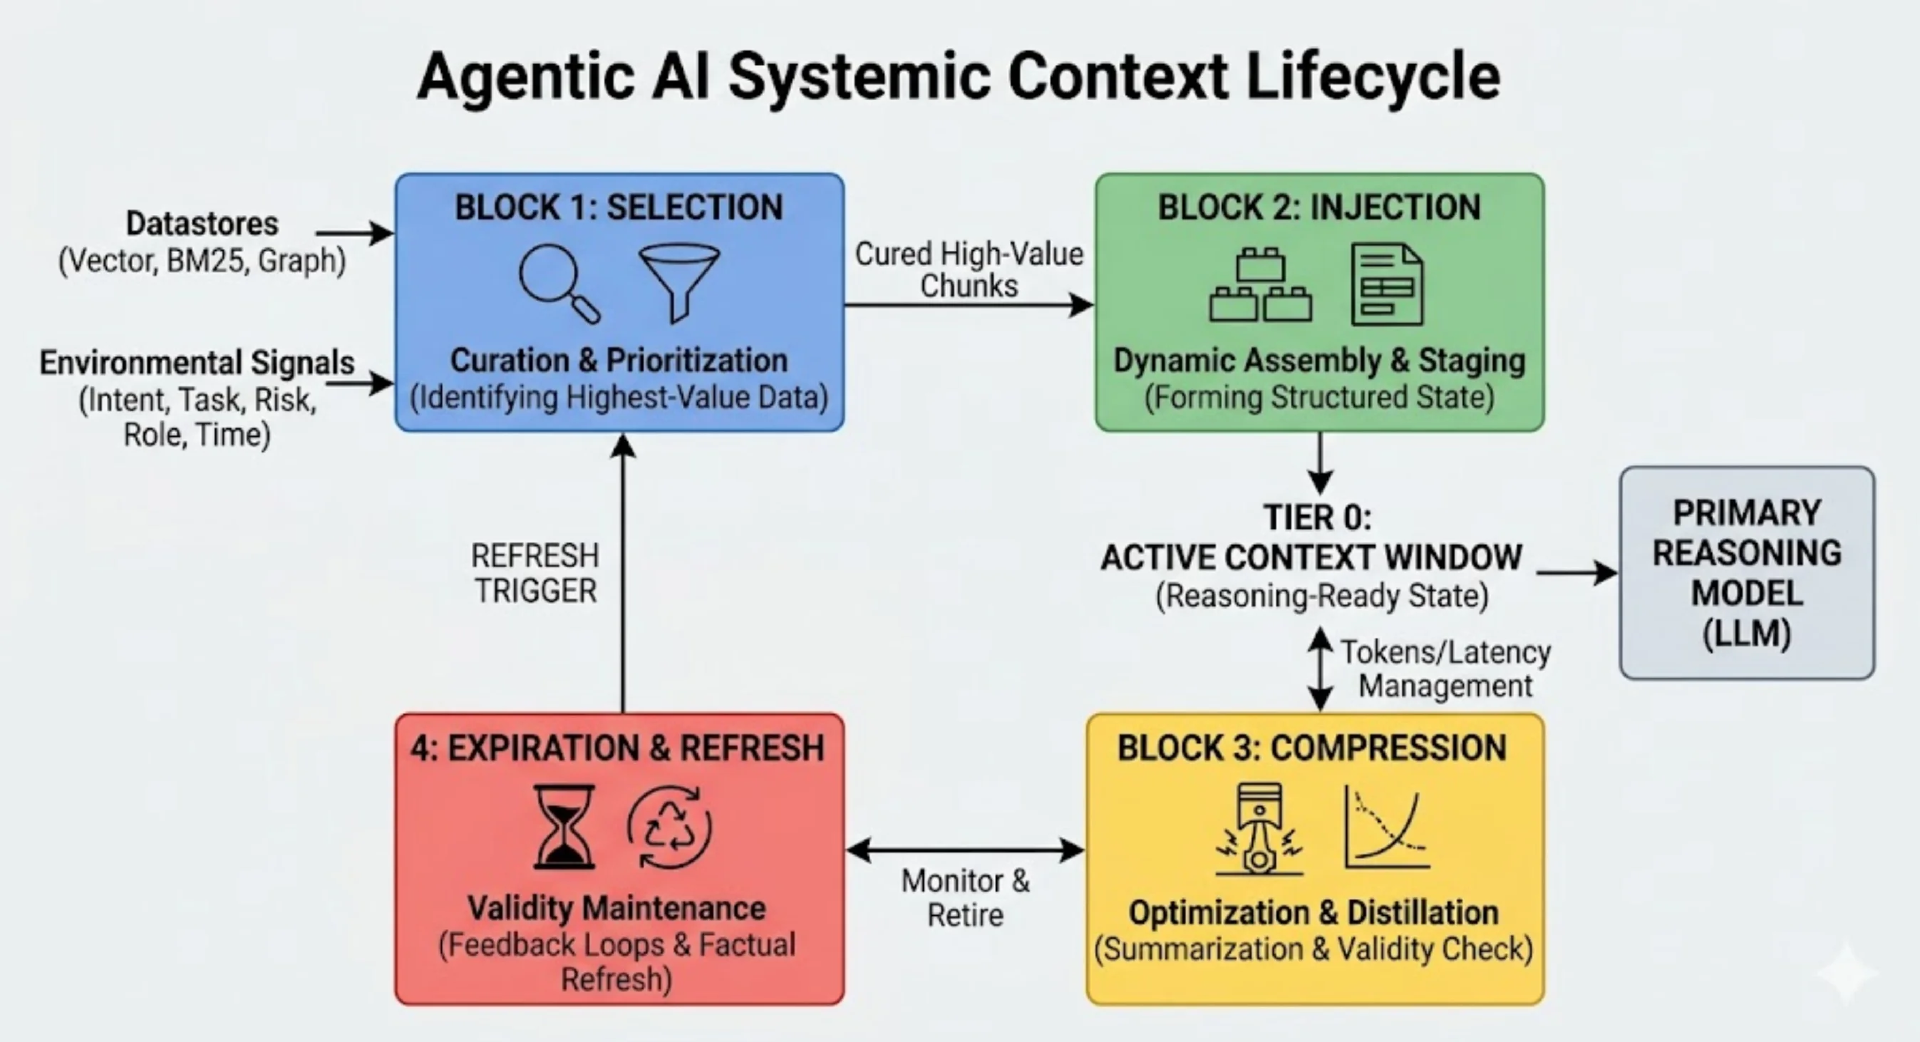
AI 系统中最常见的架构错误之一,就是把检索当作充分条件,这在语义层面相当于 SQL 的 SELECT * 。试图持续检索大量数据的架构在大规模场景下必然失败。正确的信息和数据的形态,也就是我们所说的知识,比原始数据重要得多。真正的知识提炼聚焦于累积洞见。架构不再注入原始数据,而是采用后台工作进程/机器学习管道,利用最新的系统状态对检索到的数据进行提炼、聚合和相关性排序。生命周期分为四个阶段:选择、注入、压缩、过期与刷新。选择阶段系统识别哪些数据点可能与当前任务相关,采用混合搜索算法。注入阶段将信息以适当的形式放入模型的上下文。压缩阶段利用更小、更快的大模型或确定性算法来总结对话历史或压缩长文档,满足 Token 上限约束,降低主推理模型的成本。这种系统化管理直接定位模型失败和推理成本高昂的根因,优化每百万 tokens 价格,提升 API 聚合分发效率,为开发者提供可靠接入视角,减少幻觉风险。
来源:InfoQ