
谷歌Gemini Decision 1 API登场:0.1美元每百万Token,决策准确率92.2%抢占榜单
告别逐字生成,单次传播搞定千题
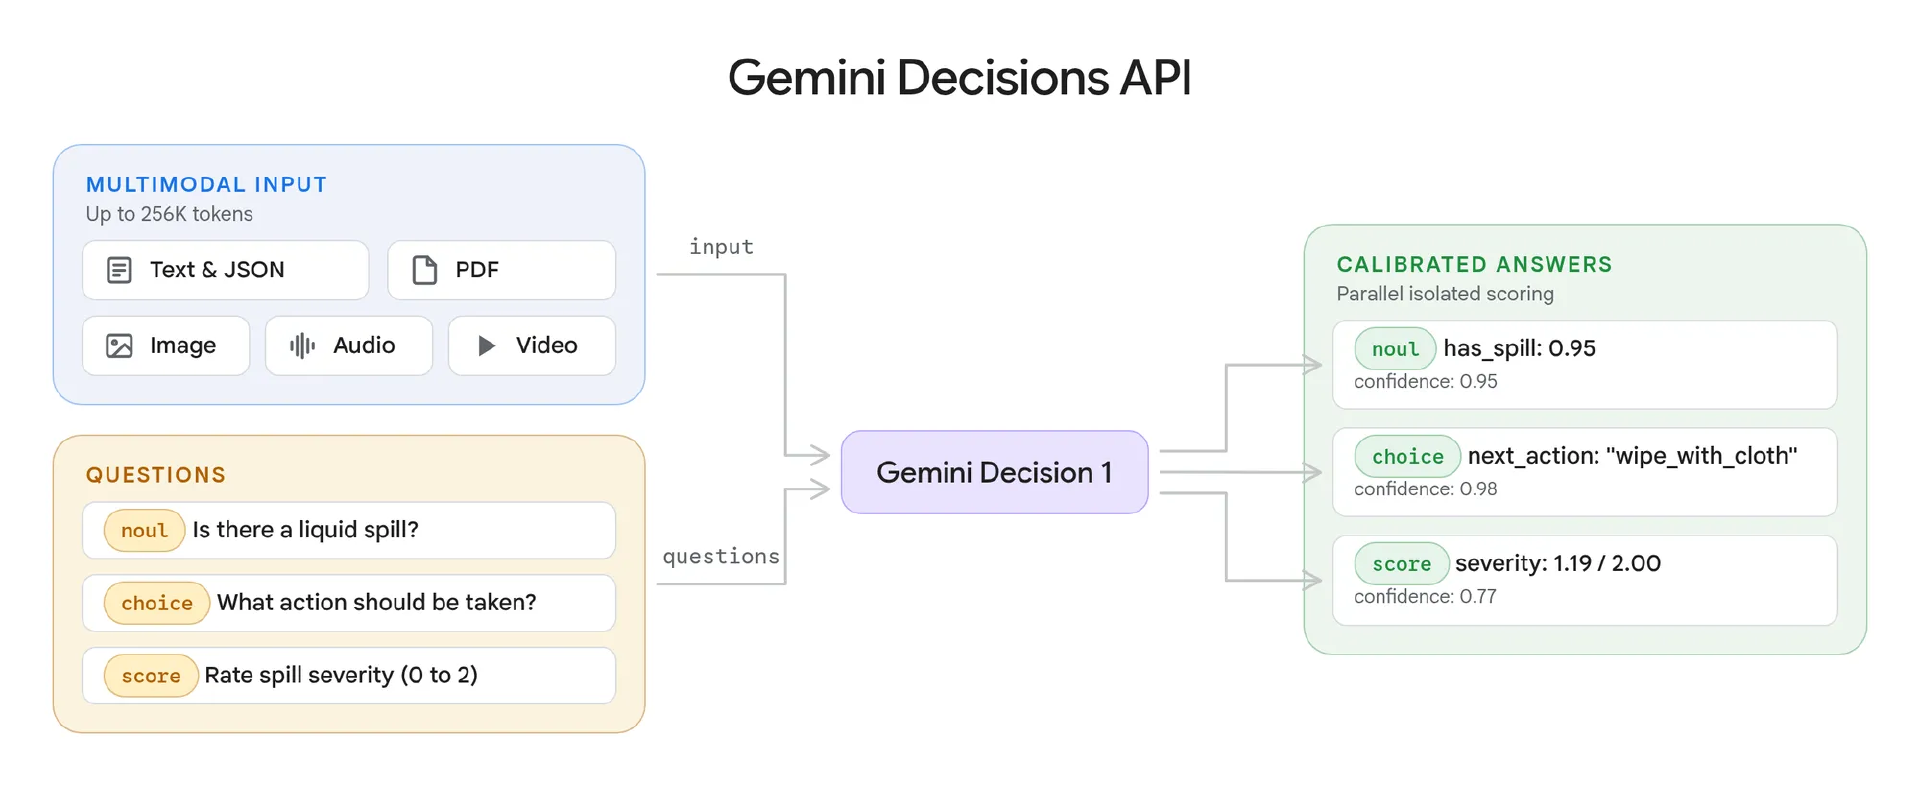
谷歌正式发布首款决策模型 Gemini Decision 1 及配套的 Gemini Decisions API。与传统生成式模型不同,该模型不通过逐Token输出答案,而是利用单次前向传播对预设候选项进行评分。它能在一次请求中处理最多 1000 个独立问题,支持文本、图像、音频、视频及PDF等多模态输入,专为封闭选项集任务设计。
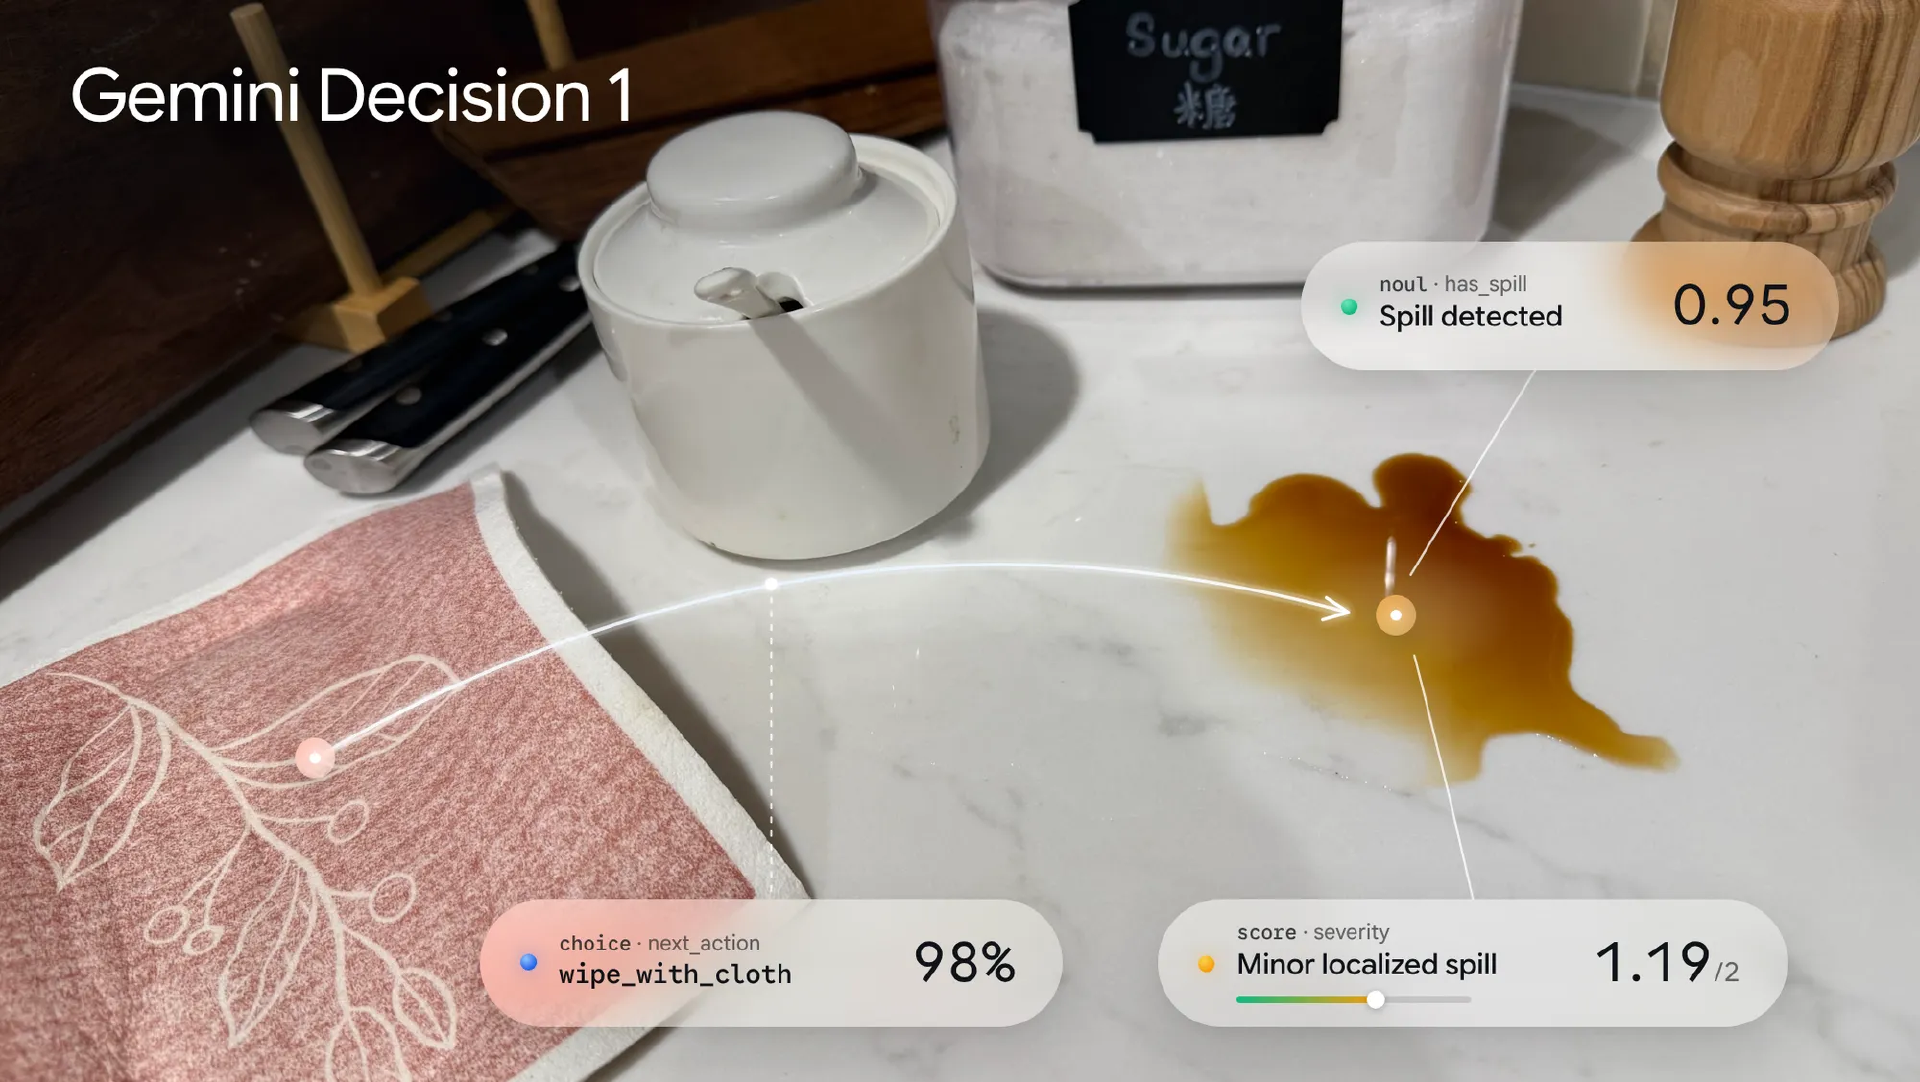
这意味着开发者无需再调用大模型生成文本后再提取结果,只需提供输入、问题和选项,模型即直接返回判断、概率及置信度。这种架构大幅简化了分类、评分或选择类任务的流程,让AI从“答题者”转变为“决策者”。
极致低价策略,输出Token零费用
在成本方面,谷歌采取了极具攻击性的定价策略。每百万输入Token价格仅为 0.10 美元,且输出Token费用为零。据官方数据,这一成本约为 Gemini 3.5 Flash-Lite 的五分之一。这种价格优势使得该模型适合高频、轻量化的决策场景,降低了企业大规模部署决策逻辑的门槛。
速度方面,在16K Token上下文内,模型计算阶段中位延迟保持在 50~100 毫秒,端到端延迟约为 150~250 毫秒。即使单次请求包含的问题数从1个增加到100个,延迟依然平稳。对于需要实时响应的Agent路由或安全检测场景,这种低延迟特性至关重要。
九项基准七项夺魁,校准误差创纪录
谷歌公布的测试成绩单显示,在 9 项基准测试中,Gemini Decision 1 拿下 7 项第一。在 JevBench 测试中,其准确率高达 92.2%,超越GPT-6 Luna的90.9%和TypeSafe Jev 1.14的90.0%。在 PubMedQA 医学问答中,它以79.8%的得分排名第一。尽管在When2Call工具调用测试中略逊于专用模型,但整体表现处于第一梯队。
更值得强调的是 概率校准 能力。在Top-1 ECE测试中,Gemini Decision 1 的校准误差仅为 0.0250,远低于GPT-6 Luna的0.0721和Flash-Lite的0.2104。低校准误差意味着模型给出的概率更贴近真实正确率,这对依赖置信度进行自动决策或人工复核的Agent系统尤为关键。
内部落地验证,路由延迟降低40%
谷歌已将该技术应用于内部产品,最典型的案例是 Gemini Notebook。Decisions API充当实时模型路由器,根据请求复杂度动态选择模型档位。对于简单日常查询,系统调用低成本模型;复杂任务则交给强模型。官方数据显示,这种动态路由方式使日常查询延迟最多降低 40%。
此外,谷歌还展示了 Stitch Rapid 在几秒内设计完整产品流程的能力,以及该模型在Agent工具选择、产品设计和安全检测中的底层支撑作用。虽然其在部分专项测试中未全面领先,但凭借极低的成本和优秀的校准特性,Gemini Decision 1 正成为构建高效AI决策基础设施的重要组件,开发者可借此优化现有系统的推理开销。
来源:InfoQ