
上下文也是成本:Snowflake 提出 Agent 效率优化新路径
Agent 的负担不在能力,而在上下文
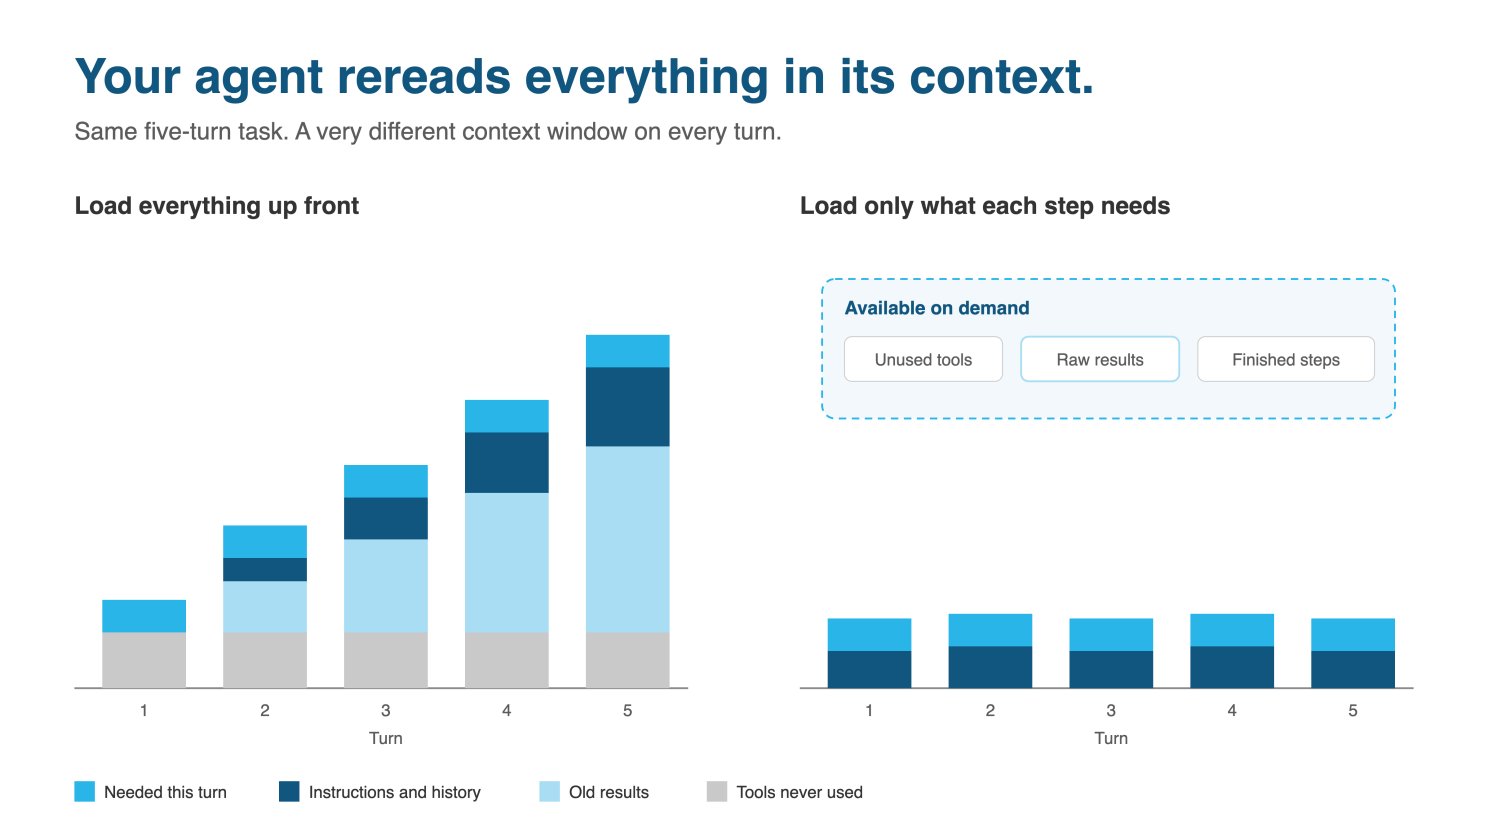
每一项工具定义、每一次查询结果、每一轮对话,都会让 Agent 需要携带的信息变多。在持续时间较长的调查任务中,这些开销不断累积,即使早期步骤的信息已经不再相关,Agent 仍可能在后续每一轮交互中反复处理它们。这就是上下文膨胀(Context Bloat)。它不仅抬高 token 消耗,也可能让 Agent 更难聚焦真正重要的信息。
单纯扩大上下文窗口并不能从根本上解决问题。更有效的思路是管理哪些信息进入上下文、哪些信息需要保留,以及 Agent 在开始执行任务之前需要掌握哪些知识。Snowflake AI Research 在 Snowflake CoCo 和 Snowflake CoWork 中探索了这一问题,提出两条相辅相成的路径:一是构建能够智能管理上下文的运行框架(Harness),二是提前为 Agent 提供业务上下文。
每一轮交互都有成本
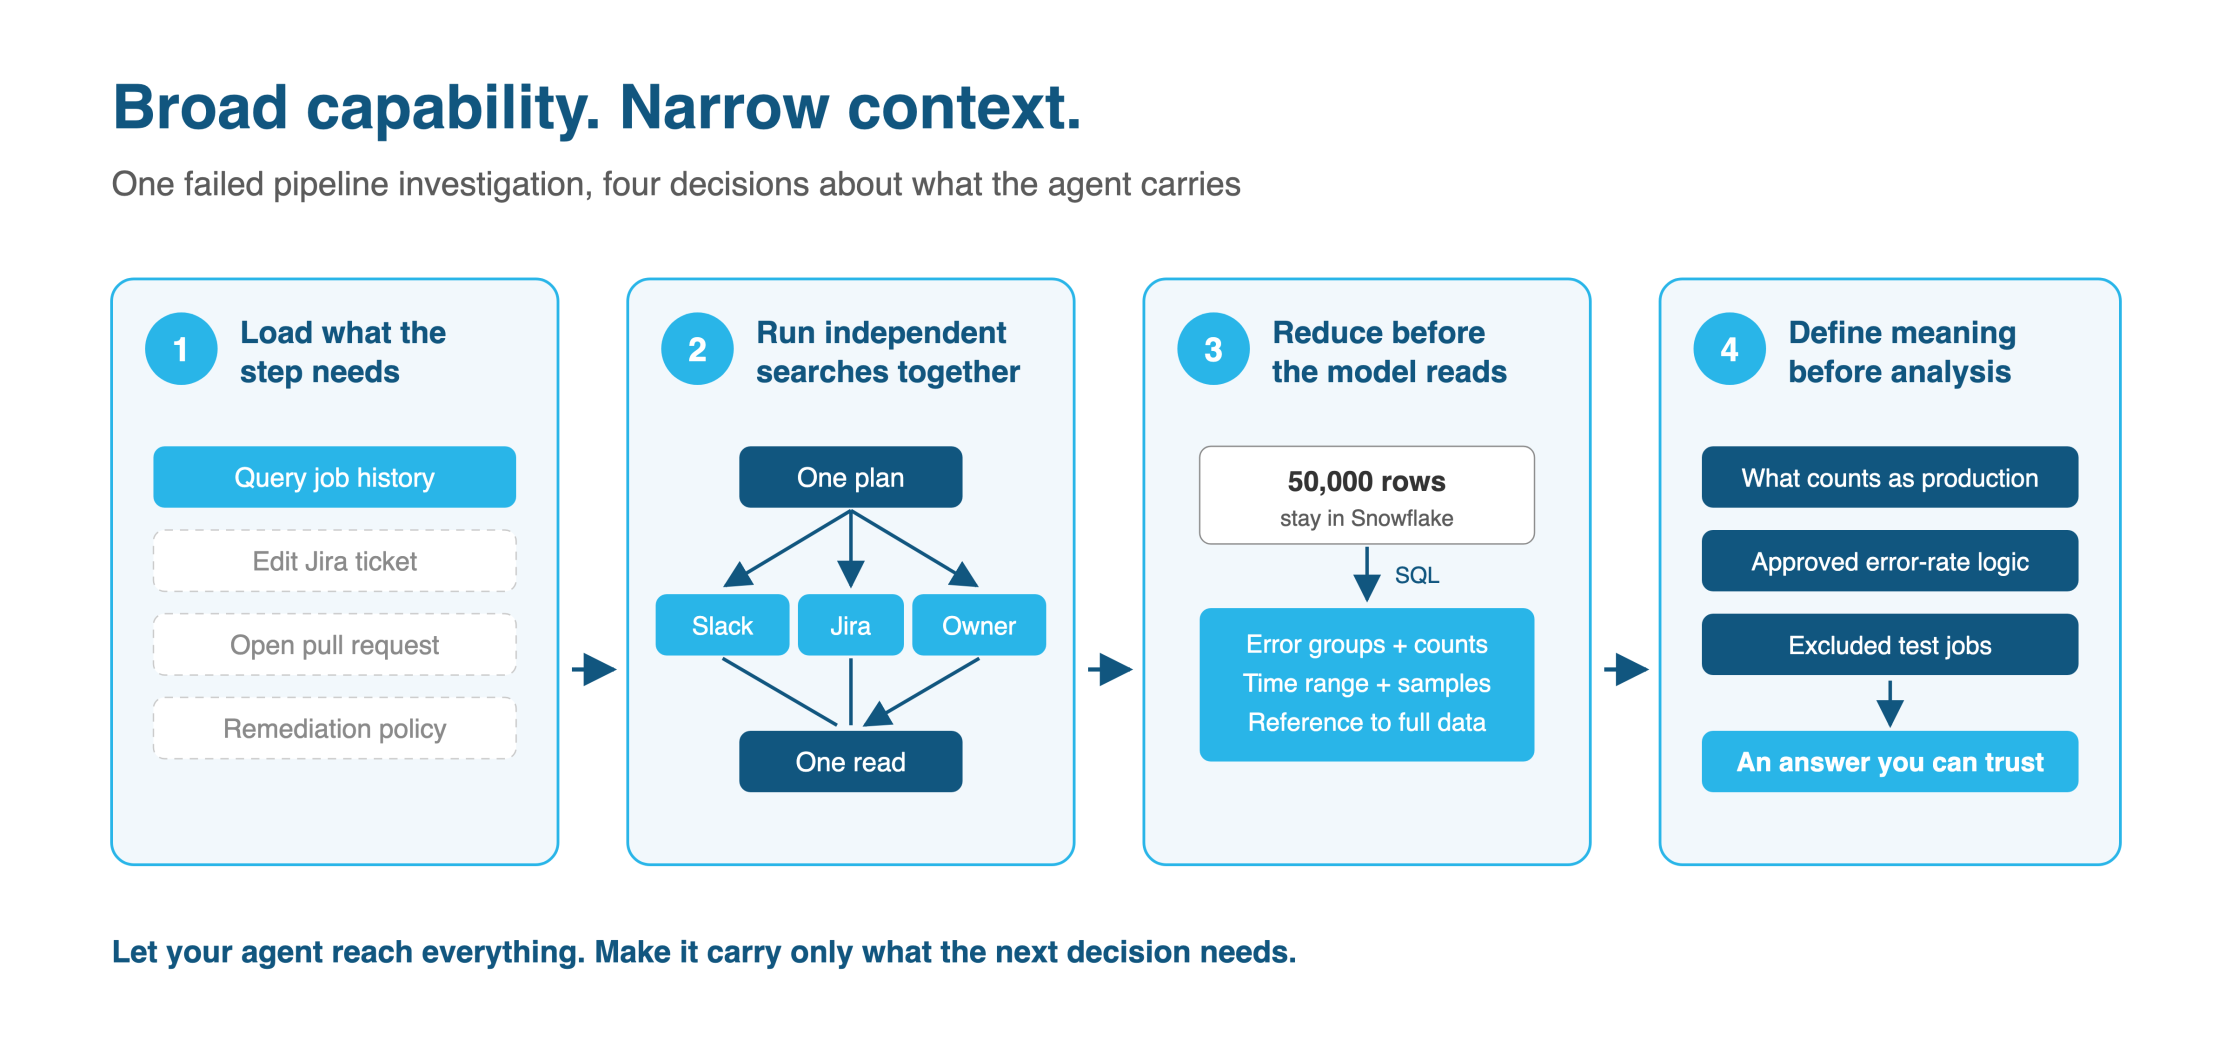
设想某条数据管道在夜间运行时发生故障。Agent 需要找出最常见的错误,在 Slack 和 Jira 中搜索相关讨论,并定位对应的代码负责人。为了完成调查,它可能需要查询 Snowflake、搜索 Slack、查找 Jira 问题记录以及检查代码。传统架构可能在调查开始前就把所有可用工具的定义加载进上下文,尽管实际只会用到其中少数工具。
随后,各种查询结果陆续返回。一次数据库查询可能返回数千行数据,一次 Slack 搜索可能返回冗长的讨论记录。每一轮交互都会向对话添加更多信息,而模型必须处理这些信息。问题并不在于 Agent 拥有太多能力,而在于它需要同时携带和处理的信息过多。
CoCo 的三项关键机制
Snowflake AI Research 团队从 Agent Harness 入手。Harness 是负责协调工具调用、管理上下文,以及连接模型与外部系统的软件层。CoCo 的 Harness 不再让模型自行处理整个过程中的所有环节,而是管理工具的发现方式、独立操作的执行方式,以及工具结果进入上下文的方式。
按需加载工具。即使 Agent 可以访问数十种工具,也没有必要从一开始就加载所有工具定义。CoCo 根据任务需要动态发现相关工具,并在实际使用时将其定义引入工作流程。这样既保留完整的工具调用能力,又不必让所有工具定义占据初始上下文空间。对于需要处理多种不同任务的通用 Agent,这一机制尤为重要。
并行执行相互独立的工具调用。如果搜索 Slack、查找 Jira 问题记录、查询数据仓库中的遥测数据之间不存在依赖关系,将它们拆分到多个模型交互轮次中依次执行就会产生不必要的开销。CoCo 可以把相互独立的工具调用合并为一次统一调度,收集执行结果后再一并返回给模型处理。当然,依赖关系仍需保证:如果某项操作依赖另一项操作的输出,就必须保留正确的执行顺序。
避免将大量结果直接放入上下文。一次查询返回数万行数据,并不意味着模型需要在后续每一轮交互中反复处理所有数据。CoCo 的方法包括压缩工具输出,并对大规模结果进行管理,让 Agent 能够利用相关信息完成任务,同时避免在整个对话过程中反复携带完整的原始输出。以数据管道故障调查为例,Agent 可以优先处理按类别汇总的错误信息、错误次数、时间戳和具有代表性的案例,并在需要时继续访问底层原始数据。
内部测试:通过率与成本的变化
在 Snowflake AI Research 的内部 SQL 修复基准测试中,使用 Sonnet 5 的 CoCo 在三次重复试验中取得了 86% 的通过率,而使用 Opus 5 的 Claude Code 通过率为 72%。同时,CoCo 每次试验的报告成本降低了 33%,从 0.446 美元降至 0.298 美元。
这些结果仅适用于测试所采用的特定配置和工作负载,并不意味着所有 Agent 都能获得相同的性能提升。不过,它们说明了一个重要问题:衡量 Agent 效率时,除了关注 token 使用量,还应结合任务完成情况进行评估。从这组数据看,上下文管理带来的收益并不只是省钱,还体现在任务通过率上。
效率之外:Agent 是否理解数据的含义
设计良好的 Harness 可以帮助 Agent 更高效地工作,但效率提升并不意味着一定能够得到正确答案。回到数据管道故障调查:Agent 已经找到了失败的任务,并计算出了错误率。但它是否知道哪些工作负载属于生产环境?是否清楚哪些测试任务应该被排除?又是否理解企业内部对错误率的具体定义?
这些业务规则未必能够直接从表名和列名中看出来。如果缺少相关信息,Agent 可能生成语法正确、能够正常执行的 SQL,并返回一个看似合理的数值,但这个结果未必符合实际的业务定义。这正是语义视图(Semantic Views)发挥作用的地方。语义视图用于描述数据在业务层面的含义,包括指标、维度、关系以及相关业务逻辑。通过提供经过治理、可重复使用的定义,Agent 就不必自行推断数据表之间的关联,也不需要反复探索某项指标的计算方式。
这里有一个重要区别:Harness 解决的是 Agent 如何高效利用上下文的问题;语义视图则帮助确保 Agent 拥有回答问题所需的正确上下文。
构建 Agent 真正需要的业务上下文
传统上,语义建模需要数据团队手动定义指标及其关联关系。Snowflake Semantic View Autopilot 可以利用现有数据、查询历史、SQL 示例以及受支持的 BI 资产自动生成语义视图,从而加快这一过程。随后,团队可以在 Semantic Studio 中审核和完善相关定义。
不必一开始就为整个企业的数据资产建立语义模型。可以先选择一个经常因指标定义不一致而产生理解偏差的业务领域,例如数据管道运行状况、客户活动、营收或客户支持表现。首先梳理业务人员最常提出的问题、用于回答这些问题的 SQL,以及相关指标背后的业务规则。以此为基础构建语义视图,再对生成的关系和定义进行审核,确认无误后投入使用。这样就能形成可复用的业务上下文,帮助 Agent 回答反复出现的问题,而无须每次都重新探索相同的数据关联和业务规则。

两条路径缺一不可
高效的 Agent 需要的不仅是能力强大的模型和丰富的工具,还需要能够智能管理上下文的 Harness,以及可靠的数据业务语义定义。减少不必要的工具定义和原始输出,有助于控制上下文开销;提供清晰的业务定义,则有助于 Agent 生成更符合企业实际需求的答案。两者缺一不可:即使工作流程足够精简,如果缺少必要的业务逻辑,Agent 仍然可能给出错误答案。
来源:InfoQ