
Harness 引擎与知识编译:Grep 重塑 RAG,解决 85% 算力冗余困境
RAG 范式面临结构性挑战
过去两年,检索增强生成(RAG)成为大模型落地企业场景的标配,但其“查询匹配排序”的传统范式正在失效。朴素 RAG 难以平衡精确日期查询与模糊概念提问,单一通路无法覆盖多样化需求。高级 RAG 虽引入 GraphRAG 等复杂架构,但部署维护成本急剧上升,效果提升并未匹配复杂度增加,系统难以在真实生产环境中长期稳定运行。
2026 年,Andrej Karpathy 提出的“LLM Wiki”概念引发行业对 RAG 根本性质疑,主张将知识编译一次而非每次查询重新推导。与此同时,PwC US 的研究报告指出,在 Agent 编排下,精确字符串匹配工具 Grep 常比语义搜索提供更高准确率,这标志着检索核心正从设计更强召回算法转向设计动态编排的决策框架。
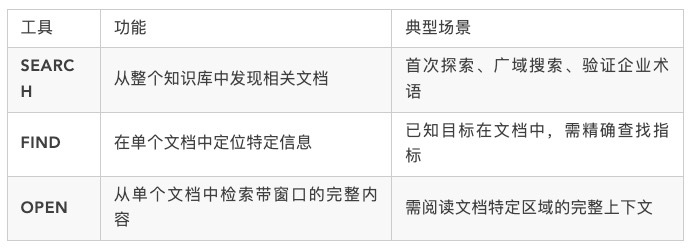
Grep 崛起与 Harness 引擎角色
Grep 的崛起并非取代 RAG,而是揭示了 Agent 编排框架(Harness)的关键价值。PwC 研究发现,简单的 Grep 工具在 Agent 动态编排下,能解决大量证据定位问题,如查找符号、追踪调用链等。OpenAI 对 GPT-5 在 BrowseComp-Plus 数据集上的行为分析显示,98% 的会话使用引号搜索,且查询长度中位数超过人类 99th 百分位,表明 AI 在精确匹配上比人类更结构化。
然而,Harness 加 Grep 组合存在明显局限。随着数据规模扩大,Agent 需反复搜索定位答案区域,导致迭代次数线性增长,Token 消耗指数上升。每一次新的上下文窗口都要重新经历探索过程,造成极高的计算资源浪费。这种“冷启动”问题使得传统 RAG 缺乏状态积累,无法持续演进认知基座,同一任务多次运行可能返回不同答案且无记录差异来源。
知识编译作为上下文供给层
为突破 Harness 的边界,知识编译成为关键的上下文供给层。其核心逻辑是将部分“理解”工作从查询时移至索引时,为 Harness 提供更丰富、更压缩、更可追溯的知识工件。Pinecone 的估算指出,Agent 有 85% 的计算精力消耗在了“重新发现”的循环上,而非真正的任务完成。知识编译正是对这一范式缺陷的系统性回应,通过预先整理和编译知识,让 Agent 以更少的迭代次数、更低的 Token 消耗精准定位答案。
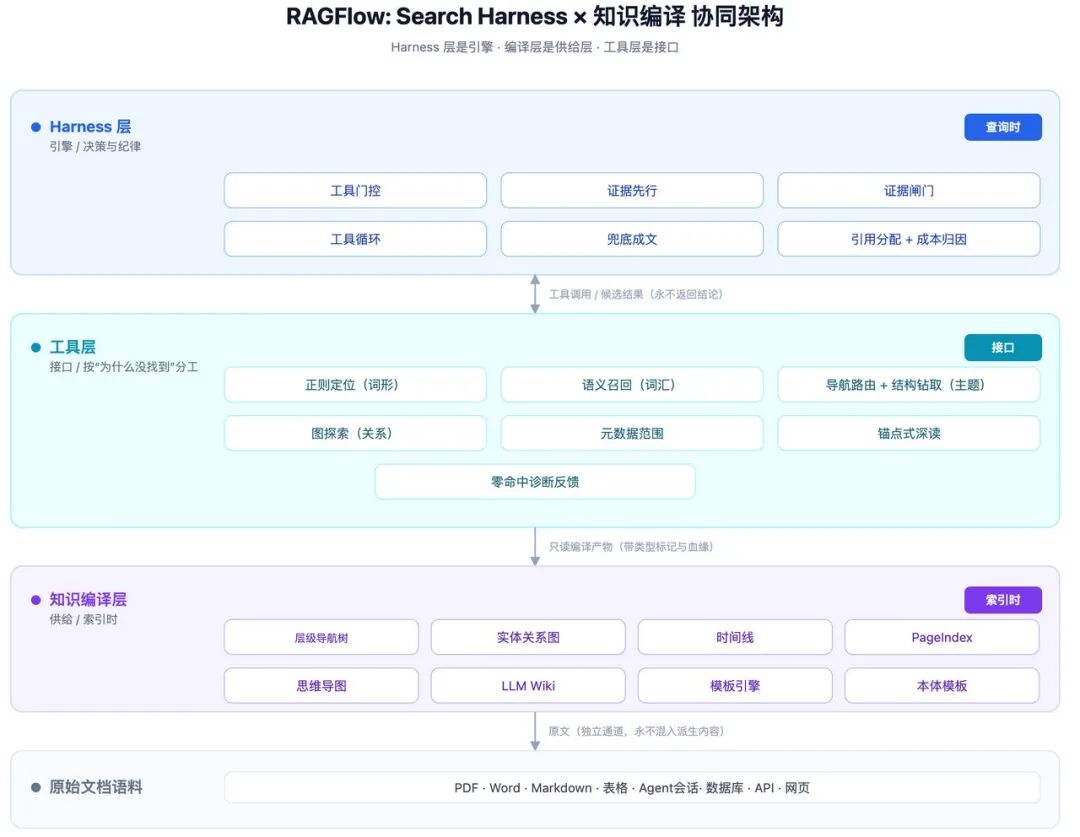
解决 RAG 四重困境的策略
传统 RAG 面临搜不准、复杂度失效、探索成本高、冷启动无状态四重困境。知识编译并非取代 Search 或 Grep,而是与之互补。它解决相似不等于相关的问题,通过编译后的知识工件减少噪音干扰;应对高级 RAG 复杂度问题,提供更易解释和维护的替代方案;缓解 Harness 探索代价,通过预编译知识缩短迭代路径;消除冷启动缺陷,建立可持续演进的认知基座,确保每次查询基于积累状态而非从零开始。
构建 Agentic Search 新架构
未来的 Agentic Search 架构应以 Search Harness 为引擎,知识编译为上下文供给层。这种架构允许 Agent 在多工具间动态编排,既保留 Grep 的精确匹配优势,又通过编译后的知识工件提升检索效率。基于 PwC 和 Pinecone 的数据判断,该方案能有效降低 85% 的无效计算消耗,解决 Token 成本指数上升问题。相比传统复杂 RAG,此架构在保持高精度的同时大幅简化维护成本,为企业级知识应用提供更具可解释性和可扩展性的技术路径。
来源:InfoQ