
智能指数v5换成私有题开榜:开源掉队12分,聚合货架的路由逻辑要换刻度
换刻度:六成权重的私有题,专治刷榜
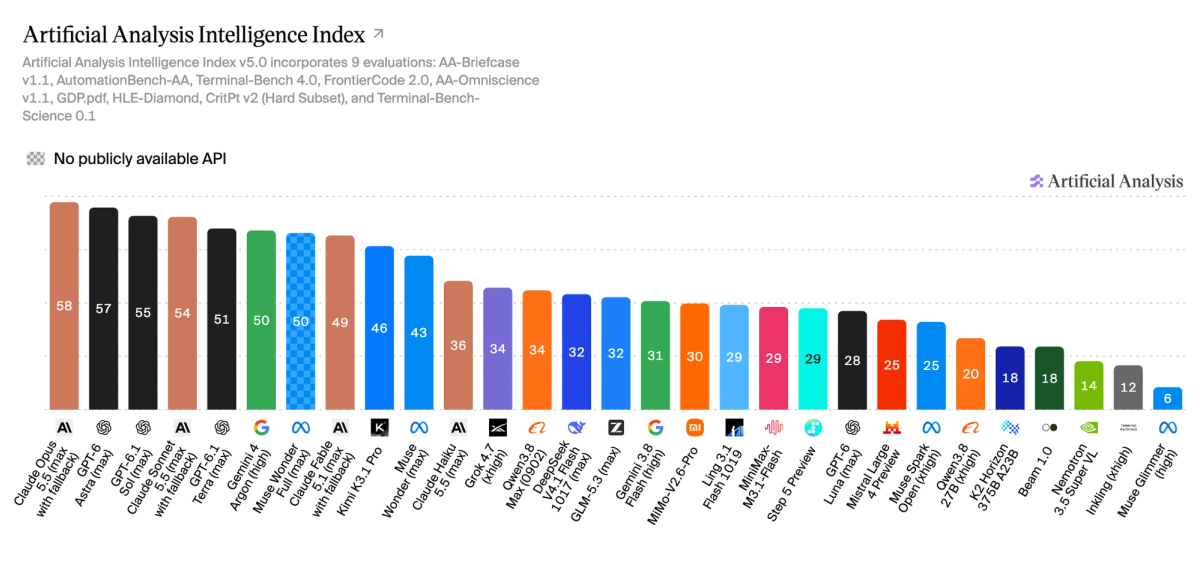
Artificial Analysis 10 月 28 日发布智能指数 v5,同步上线进度指数 v1,是 v4(1 月)以来最大一次改版:60% 的指数权重首次压在私有测试集或保留答案上,直接冲着「模型在公开题上应试刷分」的污染问题去。新增两项评测——Cognition 的 FrontierCode 2.0(132 道真实开源仓库任务,以维护者是否合并代码为判据,阻塞项不过即 0 分,数据集全程保密防污染)与 Terminal-Bench-Science(70 道终端环境科研任务,专家逐条审定);同时升级 HLE-Diamond、AA-Omniscience v1.1 与 CritPt v2 私有硬子集,知识工作、编码、科学、通用四大维度各占 25%,每道任务用自家 Stirrup 智能体框架跑三遍取均值。
开榜结果:前五两家分,开源掉队 12 分
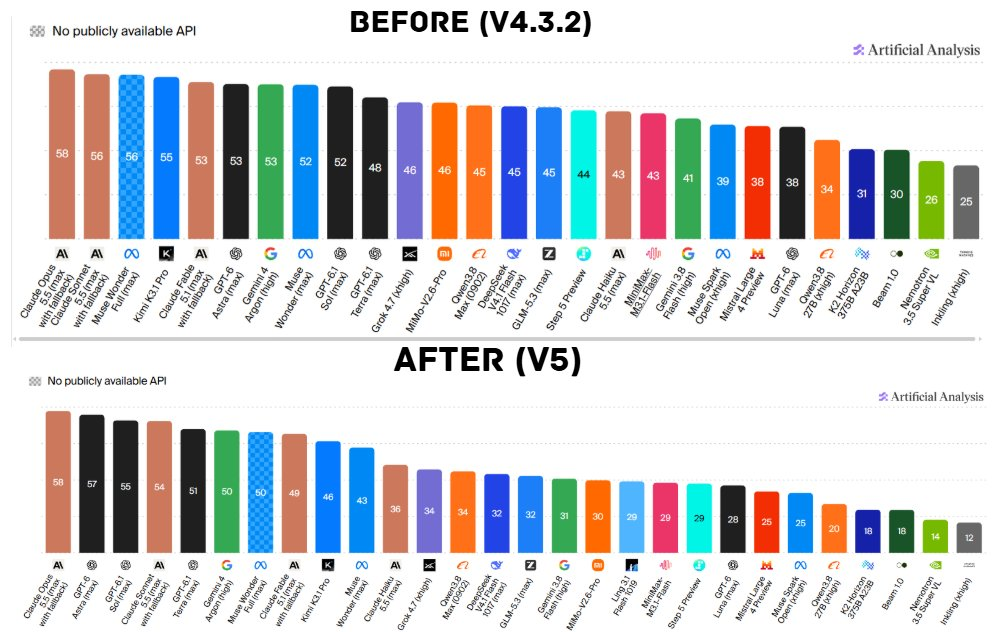
Claude Opus 5.5(max)以 58 分居首,GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,Anthropic 与 OpenAI 包揽前五,Gemini 4 Argon(high)50 分排其后。开放权重阵营明显掉队:与榜首的差距从 v4.3 的 3 分拉大到 12 分;Kimi K3.1 Pro(权重尚未放出)46 分暂列开放权重第一,已放权重的 DeepSeek V4.1 Flash 1017 与 GLM-5.3(均 max)只有 32 分,落后榜首 26 分,还低于 Claude Haiku 5.5(max,36 分)。差距最大的两项是 HLE-Diamond 与 Terminal-Bench-Science:Kimi K3.1 Pro 分别只有 37% 与 34%,Claude Opus 5.5 为 68%,GPT-6 Astra 为 63%。
还有一个细节值得标注:指数构成随版本变化,不同版本的分值不能直接比——v4.1 时期 Claude Fable 5 发布时拿到 60 分,当前榜首是 58 分,看 v5 榜单要看同版本内的相对位次与差距方向,而不是新旧分数。进度指数 v1 正是为这件事而生:用一条连续刻度追踪同一模型的能力轨迹,不随版本更替清零。
单任务成本是 v5 头条里最有货架味的新维度:得分最高的 10 款模型中,GPT-6.1 Terra(max)每个智能指数任务成本 0.96 美元最低,Claude Fable 5.1(max)13.04 美元最高,价差超过 13 倍。FrontierCode 2.0 单项上,Opus 5.5 以 46% 领先,GPT-6 Astra、GPT-6.1 Terra 与 Claude Sonnet 5.5 并列 42%,最强开放权重选手 DeepSeek V4.1 Flash 1017 为 28%。
对 API 货架的三条影响
一、能力分层换参考系。私有题占多数后,刷榜空间被压小,货架按模型能力做的路由档位与 SLA 承诺,该切到 v5 刻度上重新对表;进度指数 v1 给出一条不随版本重置的连续刻度,「模型在变强还是退化」可以沿时间轴追踪,自动换档与降级路由的误触发会明显减少。
二、单任务成本成为新的货架计价单位。过去货架比的是每百万 token 价,v5 给出的是「干完一件事花多少钱」:0.96 到 13.04 美元的 13 倍价差意味着同一条请求流里,简单任务走便宜档、难题才升级旗舰档,混合路由可以直接算出可对客户报价的成本区间,任务级定价比 token 级定价更贴近客户账本。
三、开源掉队改写自建测算。已放出的开放权重最好 32 分,连 Haiku 级 API(36 分)都超不过——「自建开源省成本」的能力下限不再稳,给客户的私有化与自建测算要加一笔能力折价;Kimi K3.1 Pro 权重放出后,这条掉队曲线值得再验一次,届时开放权重在货架上的位置或能回升。
观察:私有题占多数加任务级计价,评测方与货架方第一次站在同一张成本表上——榜单从「比谁分高」变成「比谁干同样的事更便宜」,这对 API 采购方是好消息。
来源:Artificial Analysis 官方博客、OfficeChai、StartupFortune(榜单与成本数据为 v5 发布时快照)