
调用量榜归中国模型,花钱榜还是海外领先:OpenRouter 双口径,API 分发货架该按任务重排价格档
周榜刷新:188 万亿 token,中国模型 26 周连续领先
10 月 26 日,API 聚合平台 OpenRouter 公布 10 月 19 日至 25 日周调用量数据:全平台处理 188 万亿 token,环比增长 14.6%。其中中国模型(前九口径)周调用量 93.54 万亿,美国模型约 22.5 万亿,约为其 4.2 倍——这是中国模型在该平台周调用量连续第 26 周超过美国。前九名中六席归中国模型:DeepSeek 包揽前二,MiniMax M3.1 Flash、智谱 GLM 5.3 Flash、腾讯混元 Hy4 preview 分列三至五。
头部那条数据有两套口径,引用前先分清:第一财经援引的流传数据显示 DeepSeek V4.1-Flash-1017 周调用量 33.6 万亿、环比增 801%;OpenRouter 官方页面更新后则为 35.4 万亿、环比增 382%,且 MiniMax 与 GLM 的三四名顺序对调。同一家平台的同一周数据差了 18% 的基数和 419 个百分点的增速,做引用型内容(榜单截图、周报、采购报告)时,"流传口径"与"官方口径"必须标注来源,不能混用。
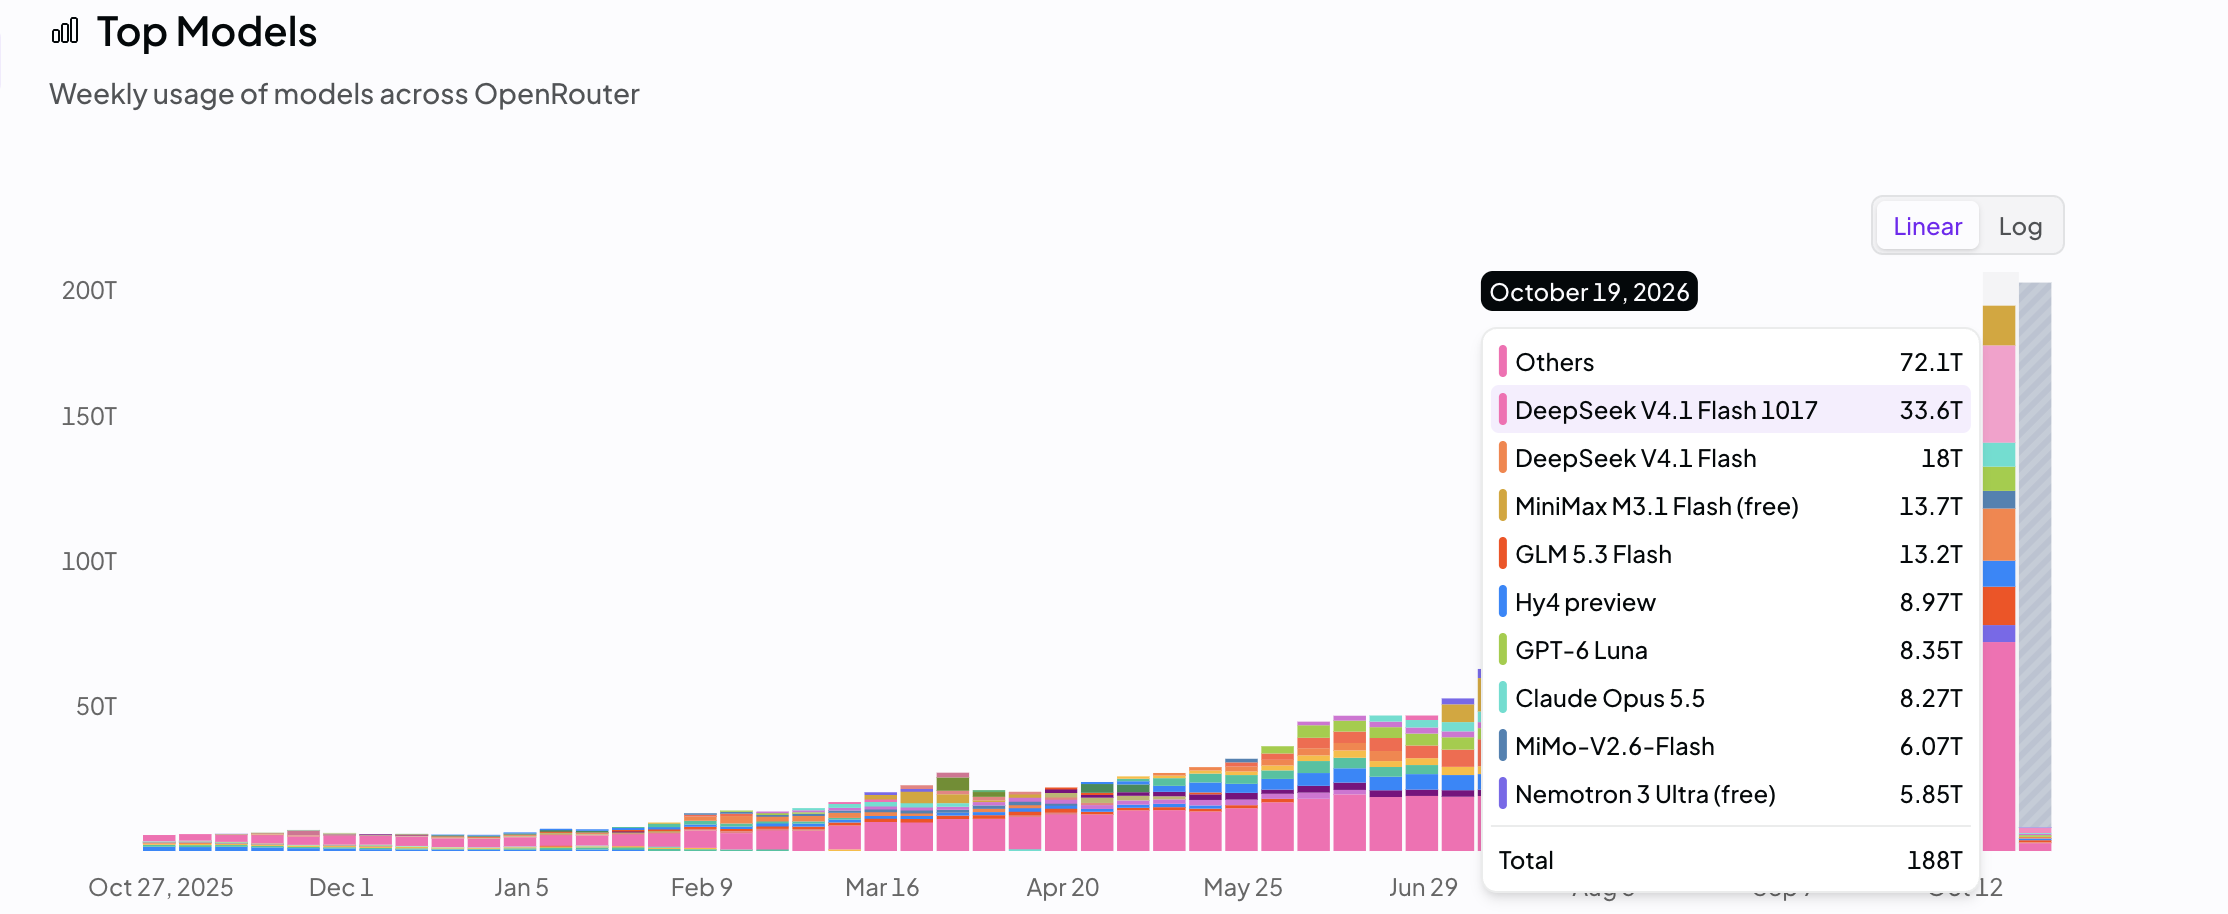
调用量榜与花钱榜,两张表讲的故事不一样
流量只是入口,钱才是货架。同一篇报道里另一个榜单(按任务类型统计的花费占比,第一财经援引)给出的画面不同:通用任务占 32.1%、Agent 占 30.9%、代码占 26.7%,这三类基本盘里,真正挑动预算的是其中的高质量细分——分类(Classification)任务中,Anthropic Claude Opus 5.5 以 10.3% 的花费份额排第一,GPT-5.6 Sol 与 Gemini 3.1 Pro 分列二、三,唯一进前四的中国模型是 DeepSeek V4.1 Flash(单一来源数据,见来源标注)。行业给出的解释很直白:高价值、高风险、对准确率要求高的任务,企业仍愿意为全球最顶级的模型付钱;大量中低风险的常规工作流才是价格敏感区,而这正是中国模型的舒适区。
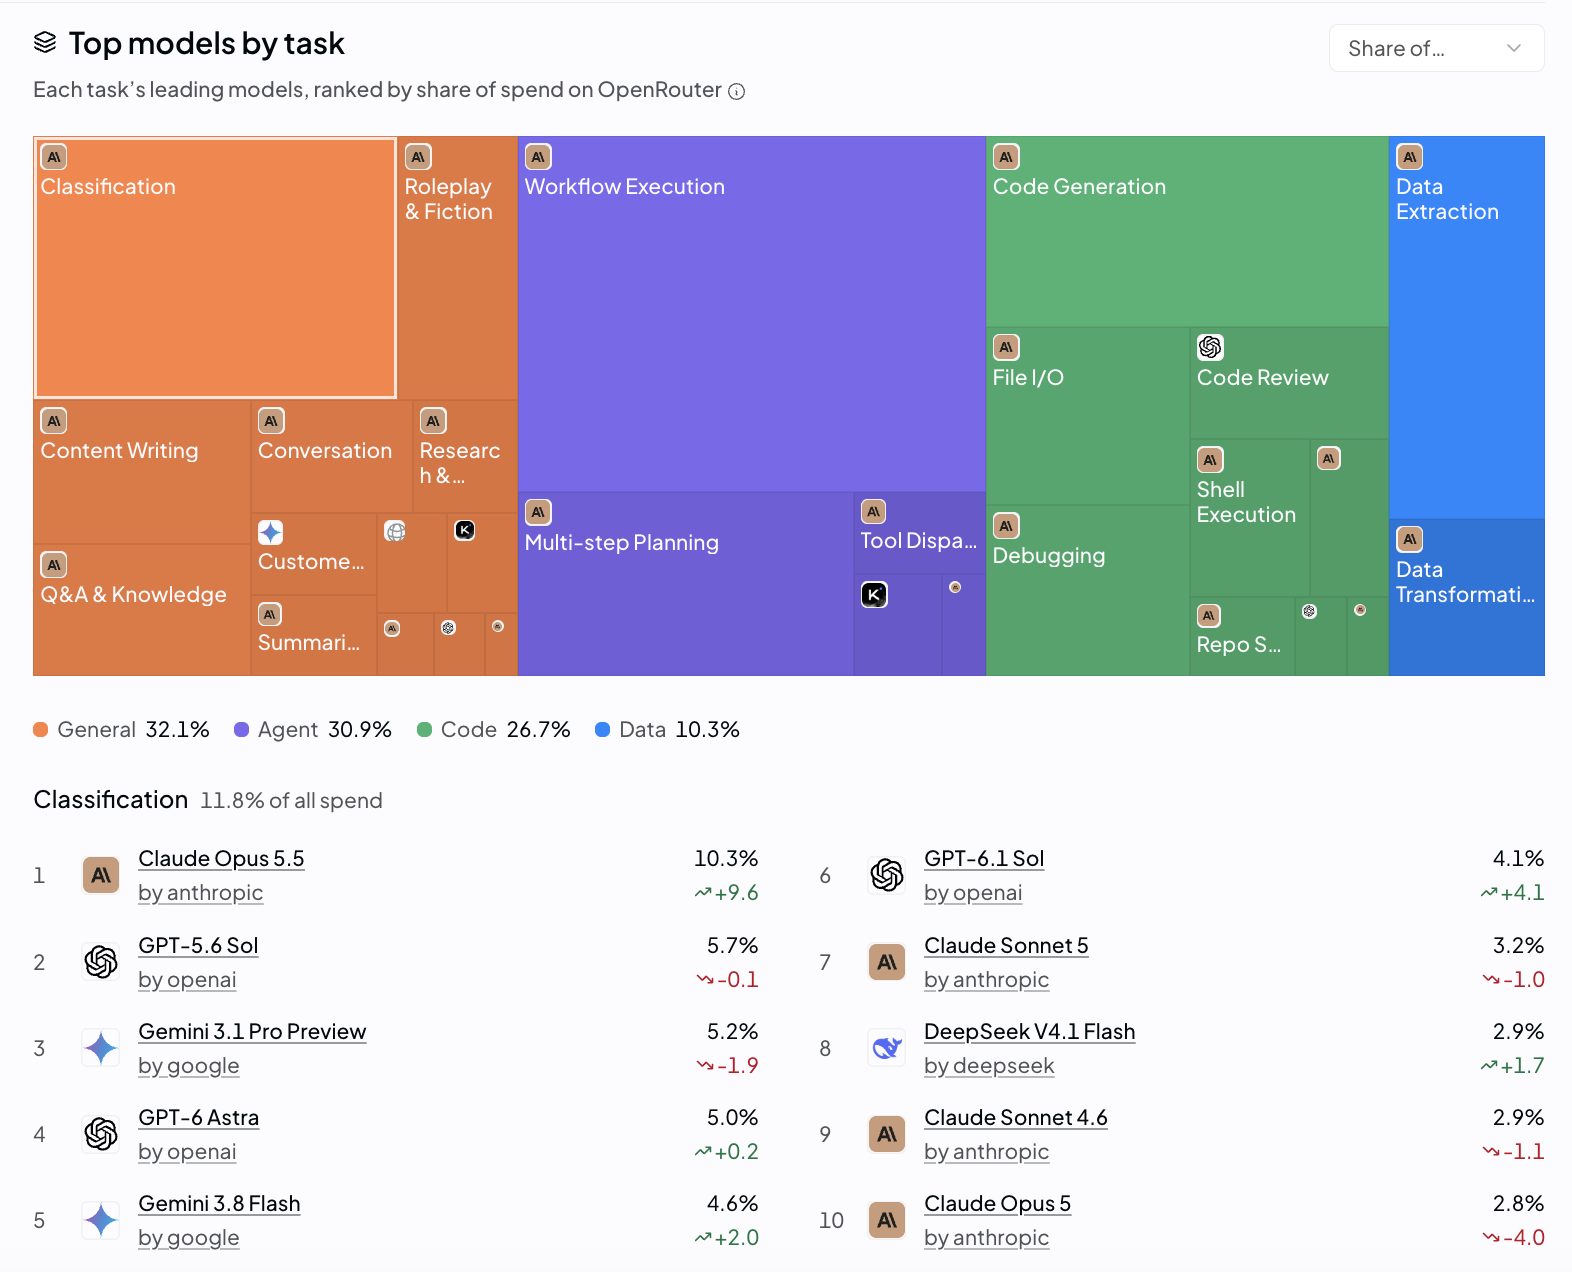
对 API 聚合分发方:三张账要重算
一、路由分层要按"任务 × 花费"二维重建。 调用量份额是渠道入口,花费份额才是毛利来源。把"任务类型 × 各任务花费占比"做成监控面板写进服务 SLA,比盯总调用量增长更有操作价值:常规高量调用(摘要、翻译、意图路由)走低价 Flash 档,分类与多步 Agent 编排保留海外旗舰通道,两档之间的迁移比例直接决定毛利结构。
二、增速差是定价档位的先行指标。 同一周里美国模型 22.47 万亿 token 环比增 29.4%,高于中国模型的 18.1%——高价值任务的花费在跑量更快的模型上增长更快。价格档若按调用量份额静态设置,会被任务结构变化套住;动态路由(按任务价值切档)才有调价空间。
三、"调用量转花费"是国产模型的定价权刻度。 26 周流量领先、分类任务花费榜前三却是海外旗舰,说明性价比拿到了入口,但定价权上限卡在高质量任务完成度上。对采购方,这条差值本身就是谈判素材:国产模型在常规任务的每百万 token 价格已经够用,旗舰场景的溢价应要求随基准(榜单)表现挂钩。
观察一句:OpenRouter 只统计经它路由的流量,厂商自有 API、云托管与端侧应用都不在口径内,这份榜单是世界地图的一角而非全图——但它恰好是 API 分发方每天都能拿到的、最贴近"钱怎么花"的免费探针。
来源:第一财经(2026-10-26,援引 OpenRouter 平台数据)、Asia Daily(2026-10-27,援引 OpenRouter 官方排行榜页);分类任务花费占比为单一来源数据。