
Ollama 开口了:31M 语音模型 Phonon 接入 OpenAI 兼容端点,聚合层开新货架类目
新货架类目:Ollama 开始分发「语音」
开源本地模型平台 Ollama 于 10 月 24 日官宣 Mac 应用正式支持文本转语音(TTS)生成,Windows 与 Linux 版本随后跟进,首批语音模型是 Gradium 的 Phonon 系列。Ollama 的 GitHub 项目已有约 18.5 万星标,是开发者「拉一个模型就能跑」的默认工具。对 API 聚合分发层而言,这不是简单的又上架一个模型:Ollama 等于把「语音模型」开成了货架上的全新类目,并且直接把这个类目接进了开发者最熟悉的 OpenAI SDK 调用规范里。目录结构从此从「语言模型为主」升级成「语言+语音」双类目并行,语音链路可以一条龙:语言模型生成内容,TTS 负责开口,中途不用换供应商。
OpenAI 兼容端点:换一行 base_url 就完成接入
Phonon 提供 OpenAI 兼容的 /v1/audio/speech 端点:现有使用 OpenAI Python 或 JavaScript SDK 的代码,把 base_url 指到 Ollama 本地服务即可切换,业务逻辑不用重写。音频随生成随流式返回,第一句话生成完就能开播放,天然适配「AI 回复边说边播」这类场景。Ollama 官方还给了管道式用法:把聊天模型的回复直接接入 Phonon,回复第一句出来就开始播,端到端延迟压到「首句时延」而不是全文生成完,语音智能体、读屏播报场景直接受益。输出为 24 kHz 单声道,默认 WAV,也可用 response_format=pcm 拿原始 16 位采样。需要提醒:单请求 4096 字符上限目前只有第三方转述一个来源,厂商自报口径,产品化前建议按官方文档复核。
性能与精度:快 35%、WER 打平基准
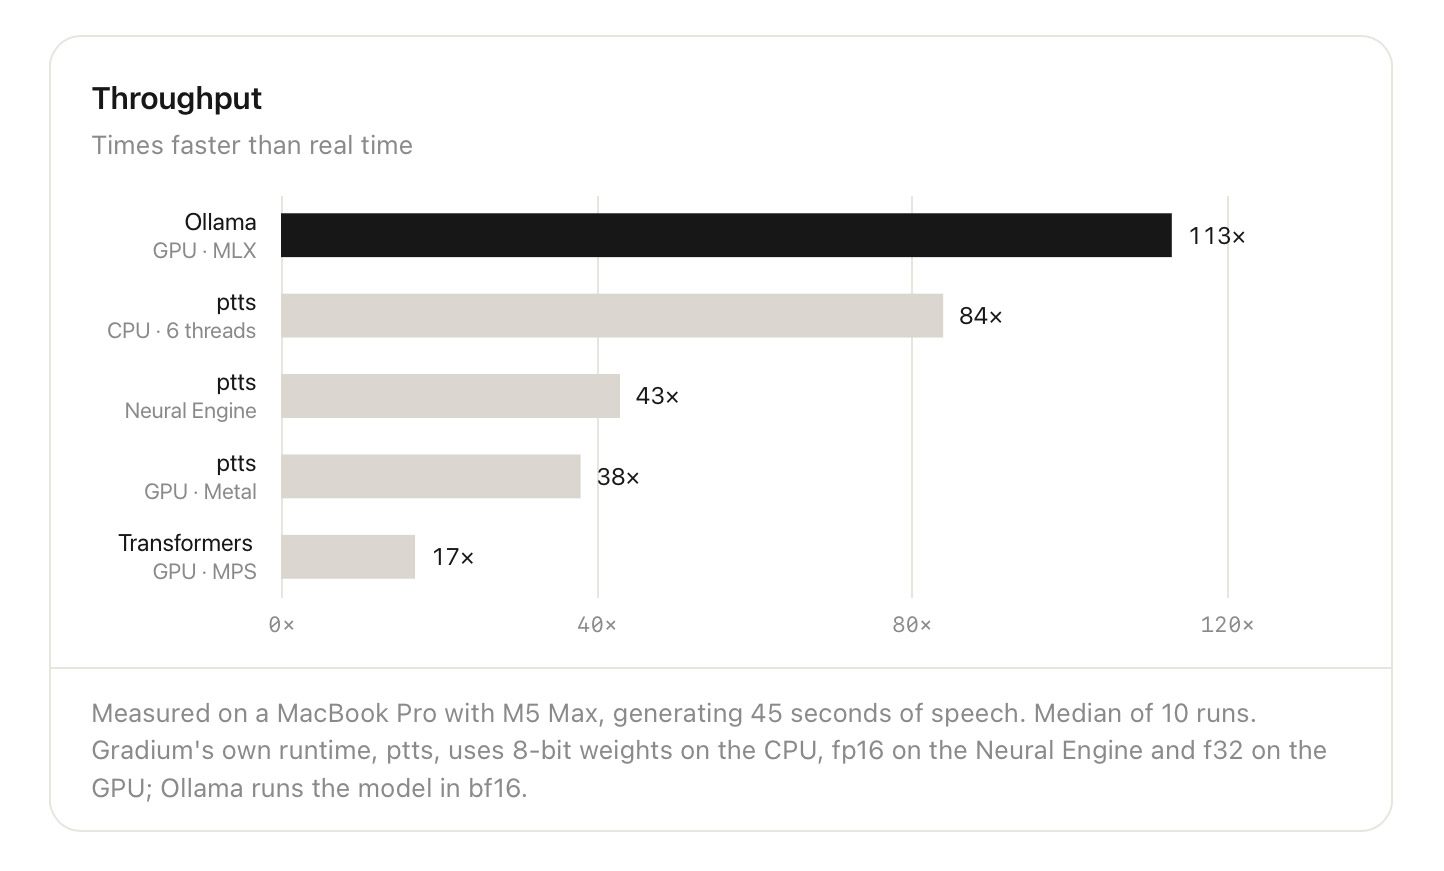
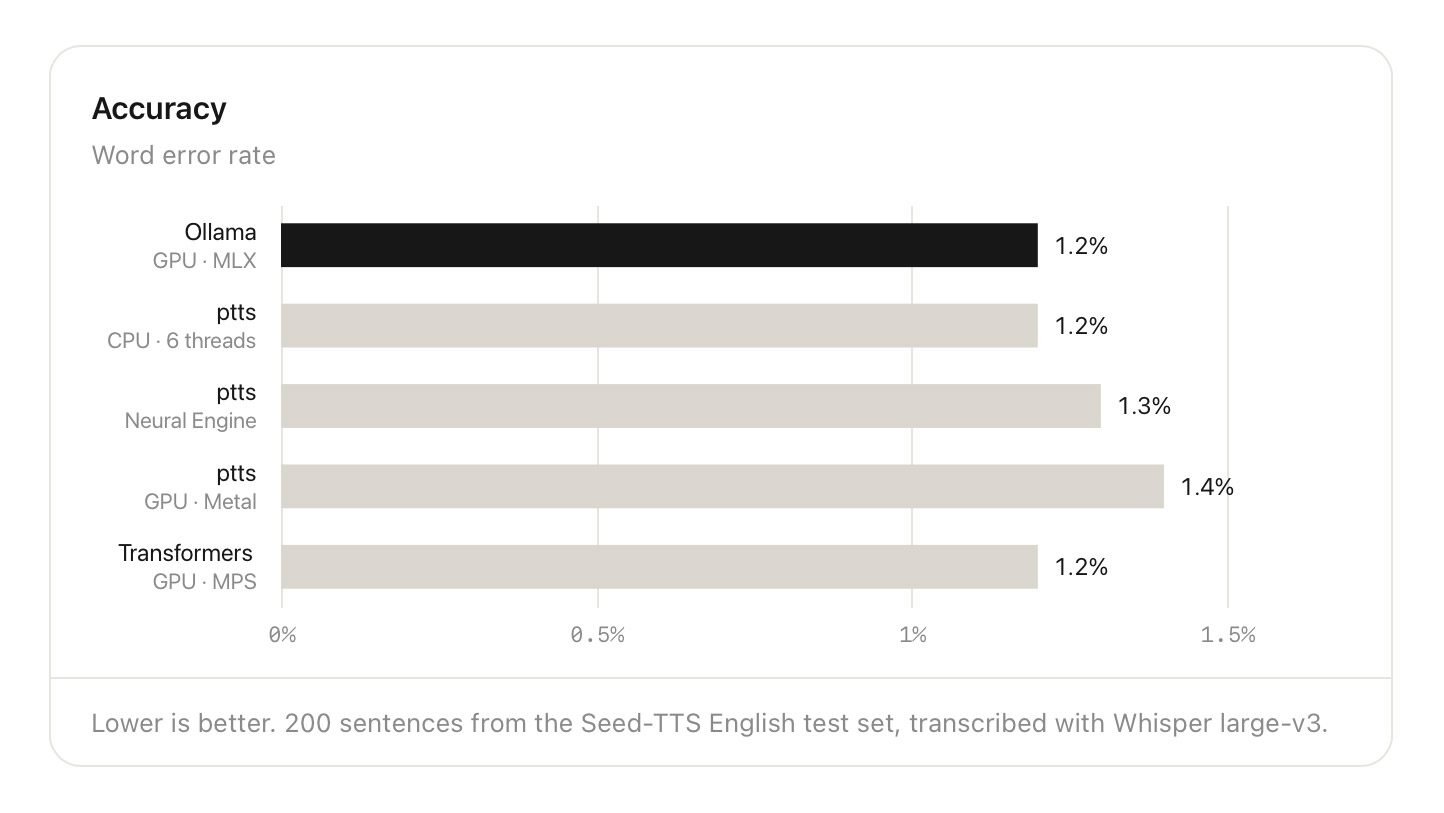
在 MacBook Pro M5 Max 上,Ollama 的语音生成比次快引擎(Gradium 自家 ptts 运行时)快约 35%,词错误率(WER)与 Hugging Face Transformers 参考实现持平;两组数据均为 Ollama 侧实测,厂商自报,暂无独立第三方基准。加速路径上,Mac 端 Ollama 跑在 Apple MLX 框架上、利用 Apple 芯片统一内存;Gradium 自家运行时用 CPU 8 位权重加 Neural Engine 与 GPU 浮点的混合精度方案,Ollama 则把模型跑在 bf16。模型体积极小:31M 英语 checkpoint 占用约 121MB 内存,40M 系列约 141MB(Ollama 模型库页面数据)。音色可从 Gradium 音色目录里选,含美式、英式口音,ollama show phonon 可列出全部可用音色。上图分别为官方吞吐与精度基准图。
选型判断:本地语音档位的成本与合规账
放进 API 采购的账本看:Phonon 的内存占用放在任何边缘设备上都近乎免费,对语音数据敏感或必须离线的场景(医疗话术播报、工厂终端、隐私敏感的客服读屏),用它替代按分钟计费的云 TTS API,单次推理成本直接趋近于零,省下的就是每万次调用的厂商溢价;代价是吞吐天花板由本机硬件决定,M5 Max 的 35% 也只是 45 秒音频中位数 10 次实测,高峰期并发要按设备算力折算。合规上有一条红线:31M 英语版是 Apache 2.0 可商用,但法德西葡及 40M 多语版全部是 CC BY-NC 4.0 非商用授权——多语商业场景现在走这条路,等于授权留了坑,聚合层上架时类目标签必须把这条写清楚。
来源:Ollama 官方博客、Ollama 模型库页、9to5Mac、IT之家;性能数据均为厂商自报。